

Quem trabalha com operação industrial conhece a cena: a informação existe, mas está espalhada entre planilhas, e-mails, PDFs e fotos de inspeção, e ninguém consegue cruzar tudo isso na hora de decidir. Entender a diferença entre dados estruturados e não estruturados é o primeiro passo para saber o que dá para consultar direto e o que ainda exige leitura e interpretação. Este texto mostra onde cada tipo aparece na rotina da fábrica e como escolher por qual começar.
A diferença em uma frase: esquema definido antes ou forma livre
A distinção central entre dados estruturados e não estruturados está no momento em que o formato é definido. Dados estruturados nascem com um esquema rígido estabelecido antes de qualquer registro: cada campo tem nome, tipo e tamanho previstos, como colunas de uma planilha. Dados não estruturados chegam sem essa moldura prévia, em forma livre, como texto corrido, imagem ou áudio, e precisam ser interpretados para revelar padrão.
Essa diferença de origem muda tudo o que vem depois: onde os dados ficam armazenados, como são consultados, que ferramentas conseguem lê-los e qual trabalho é necessário para que uma máquina os transforme em decisão.
Na prática, a pergunta que separa os dois tipos é simples: o formato foi definido antes do dado existir, ou o dado já veio pronto em forma livre? Uma nota fiscal eletrônica tem campos determinados por leiaute oficial antes de ser emitida. Um e-mail de reclamação de cliente chega do jeito que o remetente quis escrever. O primeiro é estruturado; o segundo, não.
O que são dados estruturados e por que são fáceis de consultar
Dados estruturados são aqueles organizados em um modelo previsível, geralmente tabelas com linhas e colunas, em que cada célula obedece a um tipo definido: número, data, texto com tamanho máximo, valor monetário. Por terem formato conhecido, podem ser consultados com precisão por linguagens como SQL, filtrados, somados e cruzados sem etapa de interpretação.
A facilidade de consulta vem exatamente dessa rigidez. Quando um sistema sabe que a coluna "data de emissão" sempre contém uma data no formato AAAA-MM-DD, ele consegue ordenar, agrupar por mês e calcular intervalos sem ambiguidade. Não há dúvida sobre o que significa cada valor, porque o significado foi fixado no desenho da estrutura.
Essa previsibilidade também reduz o custo de análise. Um relatório de vendas por região, um Pareto de defeitos por fornecedor ou um cálculo de giro de estoque partem de tabelas em que cada registro já está pronto para ser agregado. O trabalho está em definir bem o modelo no início; depois, a consulta é barata e repetível.
Exemplos de dados estruturados no dia a dia
- Planilhas de controle: apontamentos de parada de máquina com colunas de data, turno, equipamento, causa e duração.
- Registros de ERP: pedidos de venda, notas fiscais, cadastros de materiais e lançamentos contábeis.
- Logs de sistema: registros de acesso com horário, usuário, ação e endereço de origem.
- Leituras de sensores: temperatura, pressão e vazão coletadas em intervalos regulares e gravadas em série temporal.
O que esses exemplos têm em comum é a regularidade do formato. Cada novo registro repete a mesma estrutura dos anteriores, o que permite acumular histórico e comparar períodos sem retrabalho de organização.
O que são dados não estruturados e onde eles aparecem
Dados não estruturados são informações que não seguem um modelo predefinido de campos. Texto livre, imagem, áudio, vídeo e documentos em formatos como PDF escaneado entram nessa categoria. Eles carregam significado, mas esse significado não está organizado em colunas: está disperso na linguagem, nos pixels ou na fala.
A ausência de esquema não significa ausência de valor. Pelo contrário: a maior parte do que uma empresa sabe sobre seus clientes, seus processos e seus problemas costuma estar em forma não estruturada. E-mails trocados com fornecedores, relatórios de visita técnica, fotos de não conformidade, atas de reunião e comentários em ordens de serviço são exemplos típicos.
O custo de lidar com esse tipo de dado está na etapa de extração de estrutura. Antes de somar, comparar ou classificar, é preciso ler, reconhecer e transformar o conteúdo em algo que um sistema consiga processar. É por isso que, historicamente, esses dados ficavam fora das análises: o esforço humano para organizá-los era alto demais.
Exemplos de dados não estruturados em empresas
- E-mails e mensagens: pedidos de cliente escritos em linguagem natural, sem campos padronizados.
- Documentos digitalizados: certificados de fornecedor, laudos de ensaio e desenhos técnicos em PDF ou imagem.
- Fotos e vídeos de inspeção: registros visuais de defeitos, condições de equipamento ou evidências de auditoria.
- Áudio de reuniões: discussões de causa raiz, alinhamentos de projeto e decisões que nunca foram transcritas.
- Textos em sistemas de campo: observações livres em ordens de manutenção, descrições de reclamação e comentários de qualidade.
Em operações industriais, esses exemplos aparecem em volume crescente. A dificuldade não é gerar o dado, mas conseguir usá-lo para decisão sem que alguém leia manualmente cada registro.
Segundo REPOSITORIO, pesquisas na área de educação infantil indicam que brinquedos não estruturados promovem a imaginação, a exploração e o brincar livre, enquanto os estruturados são usados para ensinar habilidades específicas.
O Data Lake Serpro foi criado para centralizar e armazenar todos os tipos de dados de governo, integrando uma coleção diversa de dados estruturados e não estruturados para melhorar a gestão pública.
Dados semiestruturados: o meio-termo entre os dois formatos
Entre os dois extremos existe uma terceira categoria: dados semiestruturados. São dados que não seguem um esquema rígido de tabela, mas carregam alguma marcação interna que facilita a leitura. O formato mais comum é o JSON, usado em APIs, e o XML, presente em notas fiscais eletrônicas e em diversos padrões de troca de informação.
Um arquivo JSON de um pedido, por exemplo, não tem colunas fixas como uma tabela de banco relacional. Mas cada campo vem identificado por um rótulo: "cliente", "itens", "valor_total". Um sistema consegue localizar esses rótulos e extrair o conteúdo sem precisar interpretar linguagem natural. É uma estrutura flexível o suficiente para aceitar campos novos, mas organizada o bastante para dispensar adivinhação.
Na prática empresarial, dados semiestruturados aparecem com frequência em integrações entre sistemas. Quando um ERP envia um pedido para um portal ou recebe uma resposta de API, o conteúdo trafega nesse formato intermediário. Ele não é tão direto de consultar quanto uma tabela, mas é muito mais tratável que um e-mail.
Comparação prática: formato, armazenamento, análise e governança
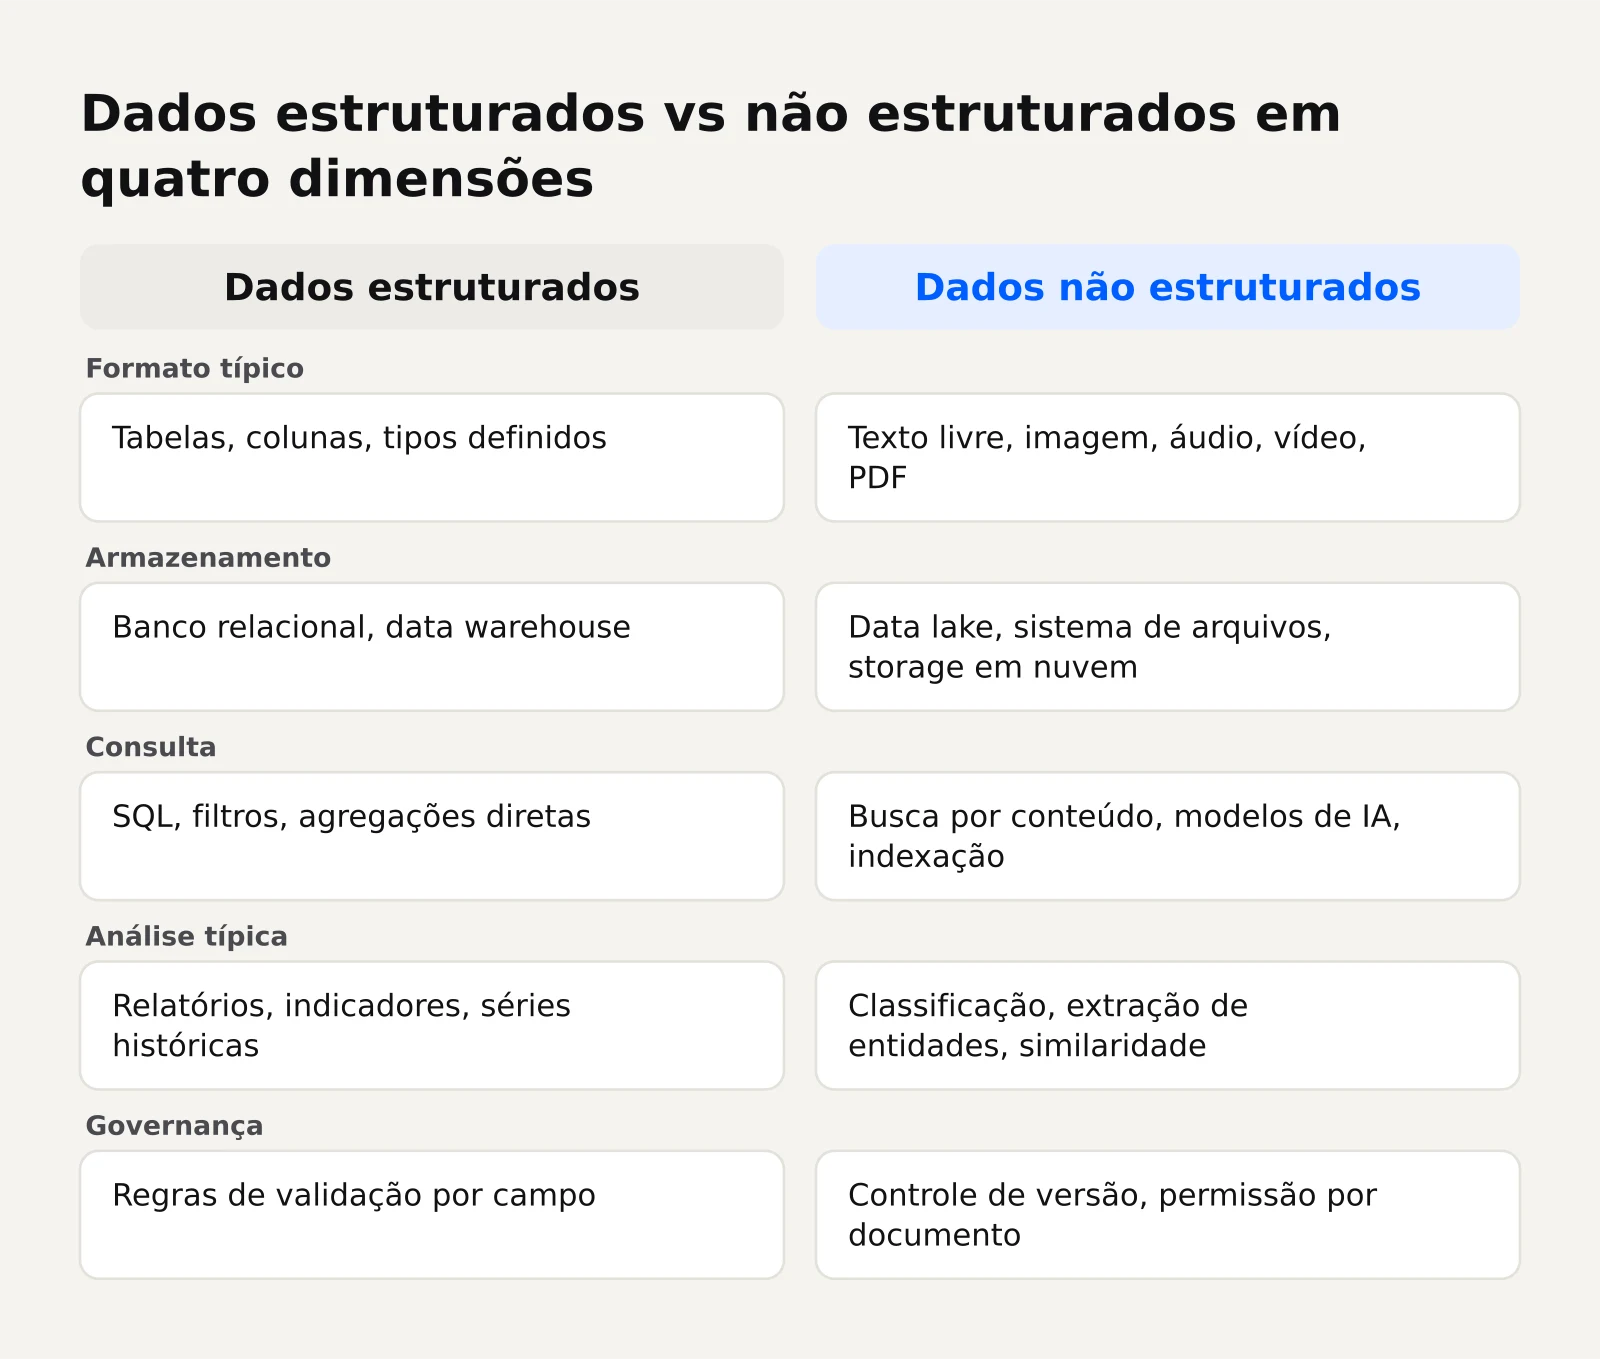
As diferenças entre os tipos de dados se manifestam em quatro dimensões práticas: como o dado é guardado, como é consultado, que análise é possível e como se controla qualidade e acesso. Entender essas dimensões ajuda a decidir onde investir esforço em um projeto real.
| Dimensão | Dados estruturados | Dados não estruturados |
|---|---|---|
| Formato típico | Tabelas, colunas, tipos definidos | Texto livre, imagem, áudio, vídeo, PDF |
| Armazenamento | Banco relacional, data warehouse | Data lake, sistema de arquivos, storage em nuvem |
| Consulta | SQL, filtros, agregações diretas | Busca por conteúdo, modelos de IA, indexação |
| Análise típica | Relatórios, indicadores, séries históricas | Classificação, extração de entidades, similaridade |
| Governança | Regras de validação por campo | Controle de versão, permissão por documento |
A tabela mostra que não há um tipo superior ao outro: há adequação ao problema. Um indicador de OEE precisa de dados estruturados de apontamento. Uma análise de causa raiz a partir de relatos de manutenção precisa lidar com texto livre. O erro é tentar forçar um formato a fazer o trabalho do outro.
Quando cada tipo exige tratamento diferente de qualidade e privacidade
Qualidade de dados estruturados se controla com regras de validação: campo obrigatório, faixa de valores permitida, formato de data, chave única. É possível automatizar a verificação porque o esperado está definido. Um cadastro de material com código duplicado ou unidade de medida inconsistente é detectável por conferência de regras.
Em dados não estruturados, a qualidade é mais difícil de aferir automaticamente. Um e-mail pode estar incompleto, ambíguo ou contraditório sem que haja uma regra simples que aponte o problema. A verificação costuma exigir leitura humana ou um modelo treinado para identificar padrões de erro, o que adiciona uma camada de incerteza que não existe na tabela.
Privacidade também muda de figura. Em uma base estruturada, é possível mascarar uma coluna inteira de CPF ou aplicar anonimização campo a campo. Em um documento não estruturado, o dado sensível pode estar em qualquer frase, em uma imagem ou em um comentário no rodapé. A proteção exige varredura de conteúdo, não apenas restrição de coluna. Essa diferença precisa ser considerada antes de subir qualquer base para uma ferramenta de IA.
Segundo CVM, dados cadastrais de fundos de investimento estruturados e não estruturados, como CNPJ, data de registro e situação do fundo, são disponibilizados diariamente em arquivos para consulta.
Como dados estruturados e não estruturados alimentam a IA
Modelos de IA consomem os dois tipos, mas de formas diferentes. Dados estruturados alimentam modelos de previsão e decisão que trabalham com variáveis numéricas e categóricas. Dados não estruturados alimentam modelos de linguagem, visão e áudio que aprendem padrões a partir de exemplos em forma livre. Um projeto de IA em operações industriais quase sempre combina as duas frentes.
Os dois tipos precisam coexistir em um mesmo repositório para gerar visão completa.
Por que a IA generativa depende tanto de texto, imagem e áudio
Modelos generativos, como os de linguagem e de visão, são treinados majoritariamente com dados não estruturados. Texto da internet, livros, legendas de imagem, áudio transcrito: é desse material que eles aprendem a reconhecer padrões de linguagem, contexto e significado. Por isso, são naturalmente aptos a lidar com o tipo de informação que antes ficava fora dos sistemas analíticos.
Essa característica tem consequência direta para a indústria. Um modelo de linguagem consegue ler um e-mail de cliente, identificar o que está sendo pedido e transformar o conteúdo em campos estruturados. Consegue olhar um desenho técnico e contar quantas peças de determinado tipo aparecem. Consegue ler um certificado de fornecedor e extrair data de validade e norma aplicável. O que antes exigia leitura humana agora pode ser automatizado, desde que haja conferência do resultado.
A ressalva importante: modelos generativos interpretam, mas não são infalíveis. A saída precisa ser validada contra regras de negócio e, em processos críticos, revisada por alguém que conheça a operação. A IA reduz o esforço de extração; não elimina a responsabilidade pela decisão.
O papel dos dados estruturados em modelos de previsão e decisão
Enquanto a IA generativa brilha na interpretação de conteúdo livre, os dados estruturados continuam sendo a base dos modelos de previsão e otimização. Previsão de demanda, cálculo de necessidade de manutenção, distribuição de carga entre rotas e priorização de ordens de produção dependem de séries históricas organizadas em tabelas.
Esses modelos funcionam melhor quando o histórico é consistente: mesmas unidades, mesmos critérios de classificação, poucos buracos na série. É por isso que a padronização de apontamentos de parada, reclamações de cliente e dados de qualidade é pré-requisito para qualquer análise preditiva séria. Sem estrutura, não há série confiável; sem série confiável, não há previsão com valor.
Na prática, um projeto de IA bem desenhado costuma usar os dois tipos em sequência: primeiro, extrai estrutura de documentos e textos livres; depois, alimenta modelos analíticos com essa estrutura recém-criada. O dado não estruturado vira estruturado, e o estruturado vira decisão.
Erros comuns ao classificar e integrar os dois tipos de dados
O primeiro erro é confundir o meio com o formato. Um dado dentro de uma planilha não é necessariamente estruturado. Se a coluna "observação" contém texto livre digitado por cada operador do seu jeito, aquela coluna é não estruturada, mesmo estando dentro de um arquivo .xlsx. A estrutura é definida pelo conteúdo e pelas regras que o governam, não pela ferramenta que o armazena.
O segundo erro é tratar todo documento como dado não estruturado sem olhar para dentro. Uma nota fiscal eletrônica em XML é semiestruturada: tem marcação, campos identificáveis e leiaute definido. Um PDF gerado por sistema, com posições fixas de campos, pode ser extraído com regras determinísticas, sem precisar de modelo de linguagem. Classificar tudo como "não estruturado" leva a usar IA onde uma regra simples resolveria, com mais custo e menos previsibilidade.
O terceiro erro é integrar os dois tipos sem definir a regra de negócio antes. Quando um texto livre precisa virar campo de sistema, alguém precisa decidir o que fazer com o que não se encaixa: pedido ambíguo, unidade de medida faltando, cliente com nome diferente do cadastro. Sem essas regras, a automação produz dados estruturados de baixa qualidade, e o problema apenas muda de lugar.
O quarto erro é ignorar a governança do dado não estruturado. Em bases estruturadas, as empresas costumam ter dono, regra de atualização e controle de acesso. Em repositórios de documentos, e-mails e imagens, esse controle frequentemente não existe. Quando esses dados passam a alimentar IA, a ausência de governança vira risco: dado desatualizado, versão errada de um desenho, informação sensível exposta ao modelo.
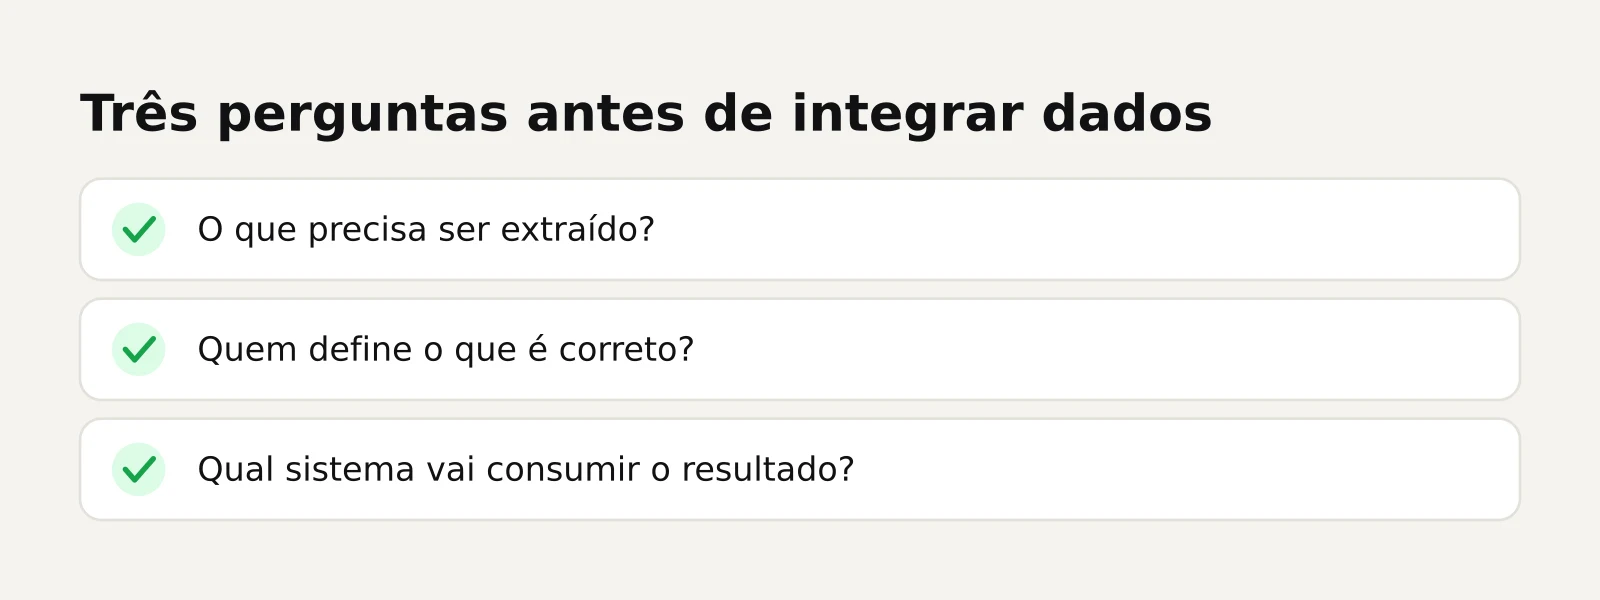
Uma forma de evitar esses erros é aplicar um critério simples antes de classificar qualquer fonte. As três perguntas abaixo ajudam a definir o caminho de integração:
- O que precisa ser extraído? Identifique qual informação do documento ou texto livre interessa para a decisão.
- Quem define o que é correto? Determine quem valida o resultado e quais regras de negócio se aplicam.
- Qual sistema vai consumir o resultado? Saiba para onde o dado estruturado vai e em que formato precisa chegar.
Se essas três perguntas têm resposta clara, o caminho de integração fica mais evidente. Se não têm, o problema não é de formato de dado, é de definição de processo.
Para quem está começando a mapear onde os dados da operação vivem e como eles se relacionam, entender o conceito de dados mestres ajuda a separar o que é referência estável do que é registro de movimento. E quando o objetivo é decidir quais processos atacar primeiro com automação, a matriz de priorização oferece um critério prático para ordenar o esforço.
Na indústria, o caminho mais comum é começar por documentos e planilhas que hoje consomem horas de trabalho manual: pedidos de cliente em e-mail, certificados de fornecedor, apontamentos de qualidade em texto livre. A extração desses dados para estrutura é o primeiro passo de um projeto de automação inteligente, que depois evolui para decisão e previsão.
Perguntas frequentes
Um PDF é dado estruturado ou não estruturado?
Depende da origem e do conteúdo. Um PDF gerado por sistema, com campos em posições fixas e valores previsíveis, pode ser tratado como semiestruturado: há uma lógica de extração possível sem interpretação de linguagem. Já um PDF escaneado de um documento manuscrito ou um relatório em texto corrido é não estruturado, porque exige leitura e interpretação para revelar os dados que interessam.
Dados não estruturados valem menos que dados estruturados?
Não. Eles têm valor diferente. Dados estruturados permitem agregação, comparação e previsão com baixo custo de processamento. Dados não estruturados concentram contexto, justificativa e conhecimento que raramente chega às tabelas. O problema histórico não era falta de valor, e sim o custo de extração. Com IA generativa, esse custo caiu, e o que estava esquecido em e-mails e documentos passou a ser aproveitável.
Preciso trocar meu ERP para trabalhar com dados não estruturados?
Não. O ERP continua sendo o sistema de registro dos dados estruturados. O trabalho com dados não estruturados acontece em uma camada anterior: extrair informação de documentos, e-mails e imagens e transformá-la em campos que o ERP consiga receber. Essa camada pode operar por API ou mesmo preenchendo a interface do sistema, sem exigir substituição do que já funciona.
Como saber se um dado é semiestruturado?
Verifique se existe marcação interna que identifica os campos. Se o arquivo tem rótulos como tags, chaves ou etiquetas que separam um valor do outro, mesmo sem tabela rígida, ele é semiestruturado. JSON e XML são os exemplos mais comuns. Se o conteúdo é contínuo e exige interpretação para saber onde começa e termina cada informação, é não estruturado.
Qual tipo de dado devo priorizar em um projeto de IA?
Priorize o dado que está travando a decisão mais cara. Se a operação sofre com retrabalho manual de leitura de pedidos, certificados ou desenhos, o alvo são os dados não estruturados. Se o problema é falta de histórico confiável para prever demanda ou priorizar manutenção, o foco é estruturar e limpar as bases existentes. O critério é o impacto na operação, não o tipo de dado em si.
Precisa de ajuda com isso?
Se a sua operação convive com documentos, e-mails e planilhas que precisam virar dado confiável para decisão, vale conversar com quem faz essa ponte todos os dias. A Studio Artemis mapeia processos com quem executa a tarefa, extrai estrutura de dados não estruturados e conecta o resultado ao ERP. Fale com a equipe.


