

Quem trabalha em operação industrial conhece a cena: o documento chega em PDF, alguém abre, lê, copia os campos para uma planilha e só depois lança no ERP. Quando o volume cresce, o retrabalho cresce junto, e cada analista registra do seu jeito. Este guia trata de extração de informação aplicada a esse cenário, mostrando onde ela se encaixa, como avaliar a qualidade antes de escalar e o que observar para decidir com segurança.
O que é extração de informação com IA
Extração de informação com IA é o processo de ler documentos não estruturados ou semiestruturados, como PDFs, planilhas, e-mails, plantas e notas fiscais, e transformar o conteúdo relevante em dados estruturados que um sistema consegue processar. Em vez de uma pessoa copiar manualmente cada campo para uma planilha ou ERP, um modelo treinado ou instruído identifica, classifica e organiza as informações automaticamente.
Na prática, isso significa converter frases soltas em campos com nome, valor e formato definidos. Um pedido de compra em PDF vira uma linha de tabela com cliente, itens, quantidades, preços e data de entrega. Um certificado de fornecedor vira um registro com número do documento, validade e norma atendida. A diferença central para a simples digitalização é que o arquivo deixa de ser uma imagem ou texto corrido e passa a alimentar sistemas de decisão.
O valor aparece quando a operação depende de volume documental. Equipes de engenharia, compras, qualidade e logística gastam horas relendo contratos, conferindo especificações e retrabalhando lançamentos. A extração automatizada reduz esse tempo e, principalmente, padroniza o que entra no sistema, evitando que cada analista registre a mesma informação de um jeito diferente.
A extração de dados de sites como o Tripadvisor tem sido usada como suporte na elaboração de indicadores do turismo de Minas Gerais, em uma iniciativa de Big Data documentada pela USP.
Extração de informação, recuperação e RAG: onde cada abordagem se encaixa
Os três termos aparecem juntos em projetos de IA, mas resolvem problemas diferentes. Extração de informação produz dados estruturados a partir do conteúdo: o resultado é um campo preenchido, uma tabela, um JSON. Recuperação de informação devolve documentos ou trechos que provavelmente respondem a uma pergunta, sem estruturar o conteúdo. RAG combina recuperação com geração: o sistema busca trechos relevantes e um modelo de linguagem escreve a resposta com base neles.
A escolha depende do que a operação precisa fazer com o documento. Se o objetivo é conferir se um holerite cumpre regras de convenção coletiva, a saída precisa ser estruturada: campo de horas extras, campo de adicional noturno, campo de desconto. Isso é extração. Se o objetivo é responder "o que a norma diz sobre adicional de insalubridade", a recuperação ou o RAG bastam. Se o objetivo é gerar um resumo de dez contratos, o RAG é o caminho.
Um erro comum é tratar RAG como substituto da extração. Quando a tarefa exige que cada documento vire registro com validação e conferência, a extração estruturada é a abordagem correta.
Como funciona o pipeline: do documento bruto ao dado estruturado
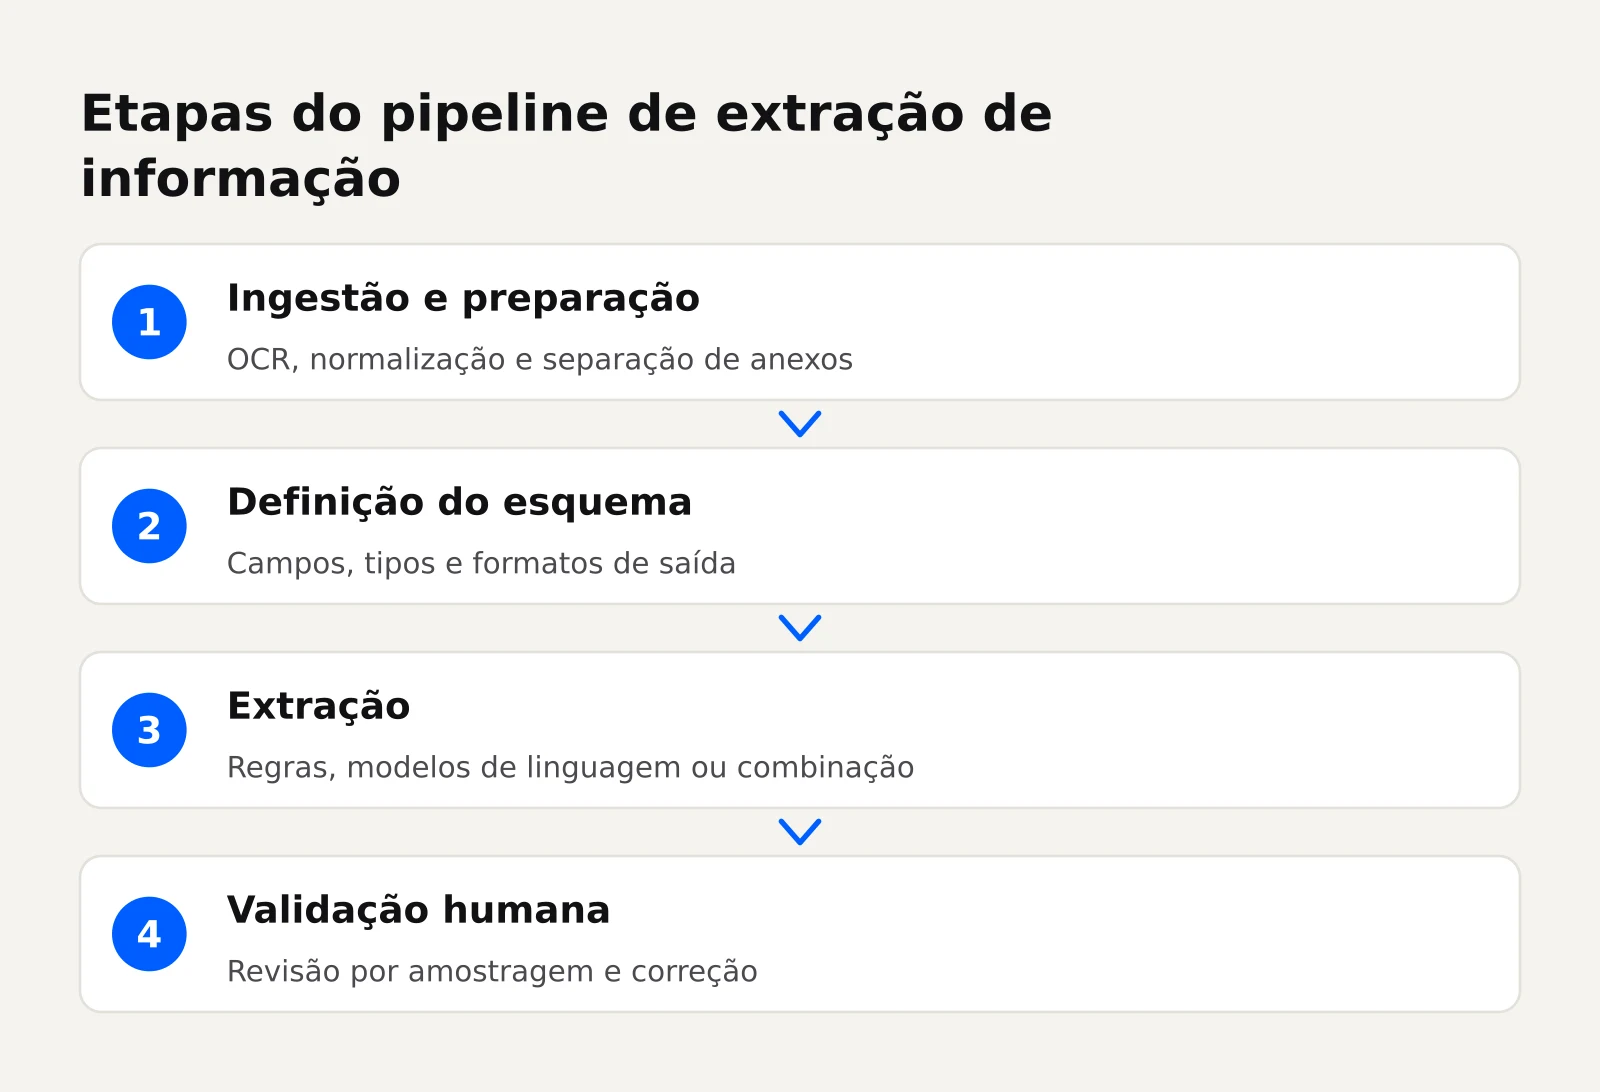
Um projeto de extração de informação segue um fluxo previsível, do arquivo original até o dado validado. Cada etapa tem decisões que afetam a qualidade final, e pular uma delas é a causa mais comum de retrabalho em implementações.
Ingestão e preparação dos documentos
O primeiro passo é garantir que o sistema receba o documento legível. PDFs escaneados passam por OCR; planilhas são normalizadas; e-mails têm anexos separados; plantas e desenhos podem exigir tratamento específico para leitura de cotas e legendas. Documentos com assinatura, carimbo ou tabela quebrada geram ruído que se propaga para as etapas seguintes.
A preparação também define a origem e a versão de cada arquivo. Sem isso, o mesmo documento processado duas vezes gera duplicidade, e não há como auditar qual versão alimentou qual registro. Em fluxos com dezenas de fornecedores ou clientes, a padronização da entrada é pré-requisito para qualquer métrica de qualidade.
Definição do esquema de saída
Antes de treinar ou instruir qualquer modelo, é preciso definir exatamente quais campos o sistema deve devolver. O esquema de saída é o contrato entre o documento e o sistema de destino: nomes de campos, tipos de dado, formatos aceitos, valores possíveis. Um campo "data de entrega" precisa dizer se aceita dia, mês e ano; um campo "unidade de medida" precisa listar as siglas válidas.
Esse esquema nasce do processo de negócio, não da tecnologia. Se o dado vai para o ERP, o esquema espelha os campos que o ERP aceita. Se vai para uma planilha de cotação, espelha as colunas que o comprador usa. Definir o esquema com quem executa a tarefa evita o cenário clássico em que a IA devolve um JSON perfeito que ninguém consegue usar.
Modelos, regras e validação humana
Com o esquema pronto, entra a camada de extração. Em documentos com formato estável, regras e expressões regulares resolvem bem. Em documentos com variação de layout ou linguagem, modelos de linguagem com instruções e exemplos funcionam melhor. Em muitos casos, a solução combina as duas: regras para campos determinísticos, modelo para campos que exigem interpretação.
A validação humana fecha o ciclo. Um revisor confere uma amostra do que o sistema extraiu, marca divergências e alimenta a correção. Essa etapa é o que transforma um protótipo em ferramenta confiável, e é onde se descobre se o esquema faz sentido para o time que vai usar o dado no dia a dia.
Principais técnicas e quando usar cada uma
Não existe técnica única para extração de informação. A escolha depende do formato do documento, do volume, da variabilidade e do nível de confiança exigido pela operação.
Regras e expressões regulares
Se o campo "CNPJ" sempre aparece depois da palavra "CNPJ" e tem 14 dígitos, uma regra resolve. Se o número da nota sempre está no canto superior direito, um recorte de região resolve.
A limitação aparece quando o layout muda. Um novo modelo de nota, um fornecedor que altera o cabeçalho, um contrato com redação diferente quebram a regra silenciosamente. Por isso, regras funcionam bem em fluxos internos controlados, como conferência de documentos padronizados, e mal em fluxos abertos com grande variedade de origens.
Reconhecimento de entidades e extração de relações
O reconhecimento de entidades nomeadas identifica e classifica elementos como pessoas, empresas, datas, valores e locais dentro do texto. A extração de relações vai além: identifica como as entidades se conectam, como "fornecedor X entrega produto Y na data Z". Essas técnicas são úteis quando o documento tem texto corrido e a informação relevante está dispersa.
Em contratos, por exemplo, o reconhecimento de entidades encontra as partes e as datas; a extração de relações liga cada obrigação à parte responsável e ao prazo correspondente. O resultado é uma tabela de obrigações que pode ser monitorada, em vez de um contrato que precisa ser relido a cada consulta.
LLMs com esquema e RAG para documentos longos
Modelos de linguagem instruídos com o esquema de saída conseguem extrair campos de documentos longos e com redação variável. O modelo recebe o texto, a definição de cada campo e exemplos do resultado esperado, e devolve o dado estruturado. Quando o documento é extenso demais para o contexto do modelo, o RAG entra para selecionar os trechos relevantes antes da extração.
Essa abordagem resolve bem casos como análise de contratos, leitura de relatórios técnicos e extração de especificações de produtos. O custo é maior que o de regras, e a explicabilidade é menor: é mais difícil rastrear por que o modelo interpretou um trecho de determinada forma. Por isso, a validação humana e a trilha de auditoria ganham peso.
Como avaliar a qualidade da extração antes de escalar
Antes de colocar um sistema de extração para processar milhares de documentos, é preciso medir se ele acerta o suficiente para a operação. As métricas centrais são precisão, cobertura e concordância com o critério humano.
- Precisão: dos campos que o sistema preencheu, quantos estão corretos. Precisão baixa gera retrabalho de conferência.
- Cobertura: dos campos que deveriam ser preenchidos, quantos o sistema encontrou. Cobertura baixa gera dado faltante no ERP.
- Concordância: em uma amostra, qual percentual das extrações coincide com o que um revisor humano decidiria. Essa métrica captura casos ambíguos que precisão e cobertura não pegam.
O teste começa com um conjunto pequeno e representativo de documentos, com o resultado esperado anotado por quem domina o processo. O sistema processa, o revisor compara, e os erros são classificados por tipo: campo ausente, valor errado, formato inválido, interpretação divergente. Cada tipo de erro aponta para uma correção diferente no esquema, nas regras ou nas instruções do modelo.
Escalar sem essa etapa é o caminho mais rápido para perder a confiança do time. A operação passa a conferir tudo manualmente, o ganho de tempo desaparece e o projeto morre na primeira semana de uso real. A medição de qualidade não é burocracia: é o que permite saber se o sistema pode operar com supervisão por amostragem ou se ainda exige conferência total.
Riscos, limites e cuidados com dados sensíveis
Extração de informação lida com documentos que muitas vezes contêm dados pessoais, informações contratuais e segredos de negócio. O primeiro cuidado é definir onde o processamento acontece e quem tem acesso ao resultado. Enviar documentos para ferramentas públicas sem avaliar os termos de uso pode violar políticas internas e legislação de proteção de dados.
O segundo cuidado é a auditabilidade. Quando a IA preenche um campo, a operação precisa conseguir rastrear de qual trecho do documento aquele valor veio. Sem isso, qualquer divergência vira uma discussão sem solução, e a equipe perde a confiança no sistema. A trilha de auditoria é o que permite revisar, corrigir e melhorar o modelo ao longo do tempo.
O terceiro cuidado é com o excesso de confiança. Modelos de linguagem podem preencher campos com valores plausíveis, mas incorretos, sem sinalizar incerteza. Em documentos com redação ambígua, o sistema precisa indicar baixa confiança para que um humano decida. A revisão humana deixa de ser opcional quando o erro tem custo alto, como em faturamento, conformidade trabalhista ou especificação técnica.
A Revista Katálysis aborda a digitalização e extração de dados da classe trabalhadora, discutindo como o capital se apropria do trabalho social na era digital.
O que define o custo de um projeto de extração de informação
O custo de um projeto de extração não está no preço de uma ferramenta, mas na complexidade do problema que ele resolve. Quatro fatores concentram a maior parte do esforço e, portanto, do investimento.
- Variedade de documentos: extrair de um modelo único de nota é simples; extrair de dezenas de formatos de fornecedores diferentes exige tratamento, testes e manutenção contínua.
- Qualidade da entrada: documentos escaneados, com baixa resolução, carimbos sobrepostos ou tabelas quebradas exigem pré-processamento e geram mais erros.
- Complexidade do esquema: dez campos simples custam menos que cem campos com regras de negócio, validações cruzadas e dependências entre si.
- Nível de confiança exigido: uma extração para relatório interno tolera mais erro que uma extração que lança dado direto no ERP ou em faturamento.
Projetos que começam pequenos, com um processo bem definido e documentos de boa qualidade, geram resultado rápido e financiam a expansão para casos mais complexos. Projetos que começam pelo documento mais difícil de toda a operação tendem a consumir orçamento antes de entregar valor.
Como escolher a abordagem para o seu caso
A decisão entre regras, modelos de linguagem ou uma combinação dos dois depende de três perguntas: quão estável é o formato do documento, qual o volume processado e qual o custo de um erro. A tabela abaixo resume os critérios.
| Critério | Regras e expressões regulares | LLMs com esquema | Combinação com validação humana |
|---|---|---|---|
| Formato do documento | Estável e previsível | Variável ou com redação livre | Misto, com campos críticos |
| Volume | Alto, com baixo custo por documento | Médio, com revisão por amostragem | Alto, com amostragem estratificada |
| Custo de erro | Baixo a médio | Médio | Alto, exige trilha de auditoria |
| Explicabilidade | Alta, regra auditável | Média, depende de instruções | Alta, com registro de decisão |
O ponto de partida recomendado é mapear o processo com quem executa a tarefa, listar os documentos que entram, definir o esquema de saída e testar com um volume pequeno. A partir do resultado medido, a abordagem técnica se torna uma consequência, não uma aposta. Para aprofundar o mapeamento antes de qualquer implementação, vale consultar um guia de documentação de processos.
Outro caso mostra o valor de envolver o time na construção. Uma indústria de válvulas de gás com 30 anos de mercado parou a agenda da equipe para uma imersão em que os próprios colaboradores escreveram processos que não estavam registrados e automações rodando com dados reais foram construídas na hora. O conhecimento de quem executa virou regra para a máquina, em vez de ficar preso na cabeça de poucos especialistas.
Perguntas frequentes
A extração de informação substitui a equipe que faz lançamento manual?
Não. Ela substitui a tarefa repetitiva de copiar e conferir campos, não o julgamento de quem entende o processo. A equipe passa a revisar exceções, validar casos ambíguos e melhorar as regras, em vez de digitar o mesmo dado centenas de vezes. Em operações com volume alto, o ganho de tempo costuma ser maior que a redução de pessoas, porque o mesmo time absorve mais demanda sem aumentar o quadro.
Preciso trocar o ERP ou dar acesso ao banco de dados para usar extração de informação?
Não necessariamente. A extração pode gerar arquivos estruturados que o time importa no sistema atual, ou a IA pode operar a interface do ERP preenchendo os campos como um usuário faria. A integração direta por API é uma opção quando o ERP permite, mas não é pré-requisito para começar. O importante é definir o esquema de saída compatível com o que o sistema aceita.
Que tipos de documento a extração com IA consegue processar?
PDFs, planilhas, e-mails, notas fiscais, contratos, certificados, relatórios, plantas e desenhos técnicos. O desempenho depende da qualidade do arquivo e da clareza do esquema de saída. Documentos escaneados exigem OCR; desenhos exigem tratamento específico para leitura de legendas e quantidades. A extração funciona melhor quando o documento contém a informação de forma legível, mesmo que o formato varie.
Como saber se a extração está boa o suficiente para escalar?
Medindo precisão, cobertura e concordância em uma amostra representativa, com o resultado esperado anotado por quem domina o processo. Se a concordância com o critério humano estiver alta e os erros forem de baixo impacto, o sistema pode operar com revisão por amostragem. Se os erros forem frequentes ou caros, é preciso ajustar o esquema, as regras ou as instruções antes de aumentar o volume.
Dá para usar extração de informação em documentos com dados sensíveis?
Sim, desde que o processamento respeite as políticas de privacidade e a legislação aplicável. O cuidado central é definir onde o documento é processado, quem acessa o resultado e como a trilha de auditoria registra cada campo extraído. Ferramentas públicas sem avaliação de termos de uso não são adequadas para dados pessoais ou contratuais. A validação humana e o registro de origem de cada campo são obrigatórios nesses casos.
Precisa de ajuda com isso?
Se a sua operação tem documentos que hoje são lidos e relançados manualmente, a extração de informação com IA pode ser o primeiro passo para liberar tempo do time e reduzir erro de lançamento. Converse com a equipe para identificar os processos com maior custo de tempo e mão de obra.


