

Quem lidera operações na indústria conhece a cena: tarefas que deveriam levar minutos consomem horas entre planilhas, ERPs e portais que não se falam, e ninguém sabe ao certo onde o tempo se perde. A suspeita existe, mas falta evidência do trabalho real. Este texto mostra como o task mining revela esse esforço escondido, como interpretar o que ele captura e quais critérios usar para escolher, com segurança, o que vale automatizar primeiro.
O que é task mining: definição e o que ele captura
Task mining é a prática de registrar, em tempo real, as interações das pessoas com sistemas e aplicativos para descobrir como as tarefas realmente são executadas. Em vez de confiar na descrição oficial de um processo, a abordagem captura cliques, digitações, copiar e colar, trocas de tela e tempo gasto em cada etapa. O objetivo é enxergar o trabalho como ele acontece, não como deveria acontecer.
O que o task mining captura vai além de um simples log de atividades. A coleta inclui o caminho percorrido entre telas e campos, a sequência de ações dentro de cada sistema, os atalhos usados, as pausas entre uma ação e outra, e os desvios que a pessoa faz para contornar limitações do software. Esses dados, quando agregados, revelam padrões que dificilmente apareceriam em uma entrevista ou em um fluxograma desenhado em reunião.
Na indústria e em operações B2B, isso tem um valor específico. Muitas tarefas administrativas e de back-office envolvem planilhas, ERPs e portais que não conversam entre si. A pessoa copia um dado do pedido, cola em uma planilha, confere no sistema, volta para a planilha, ajusta uma exceção. O task mining mostra exatamente onde esse esforço se concentra, quantas vezes se repete por dia e quais variações existem entre um executor e outro.
É importante diferenciar o que o task mining captura do que ele interpreta. A ferramenta registra eventos de interação; a interpretação sobre o que aquilo significa para o negócio vem depois, com análise humana e, cada vez mais, com apoio de IA. O dado bruto é o ponto de partida para perguntas como: onde está o retrabalho? Qual etapa consome mais tempo? Quais exceções quebram o fluxo padrão?
Como o task mining funciona na prática, do registro à análise
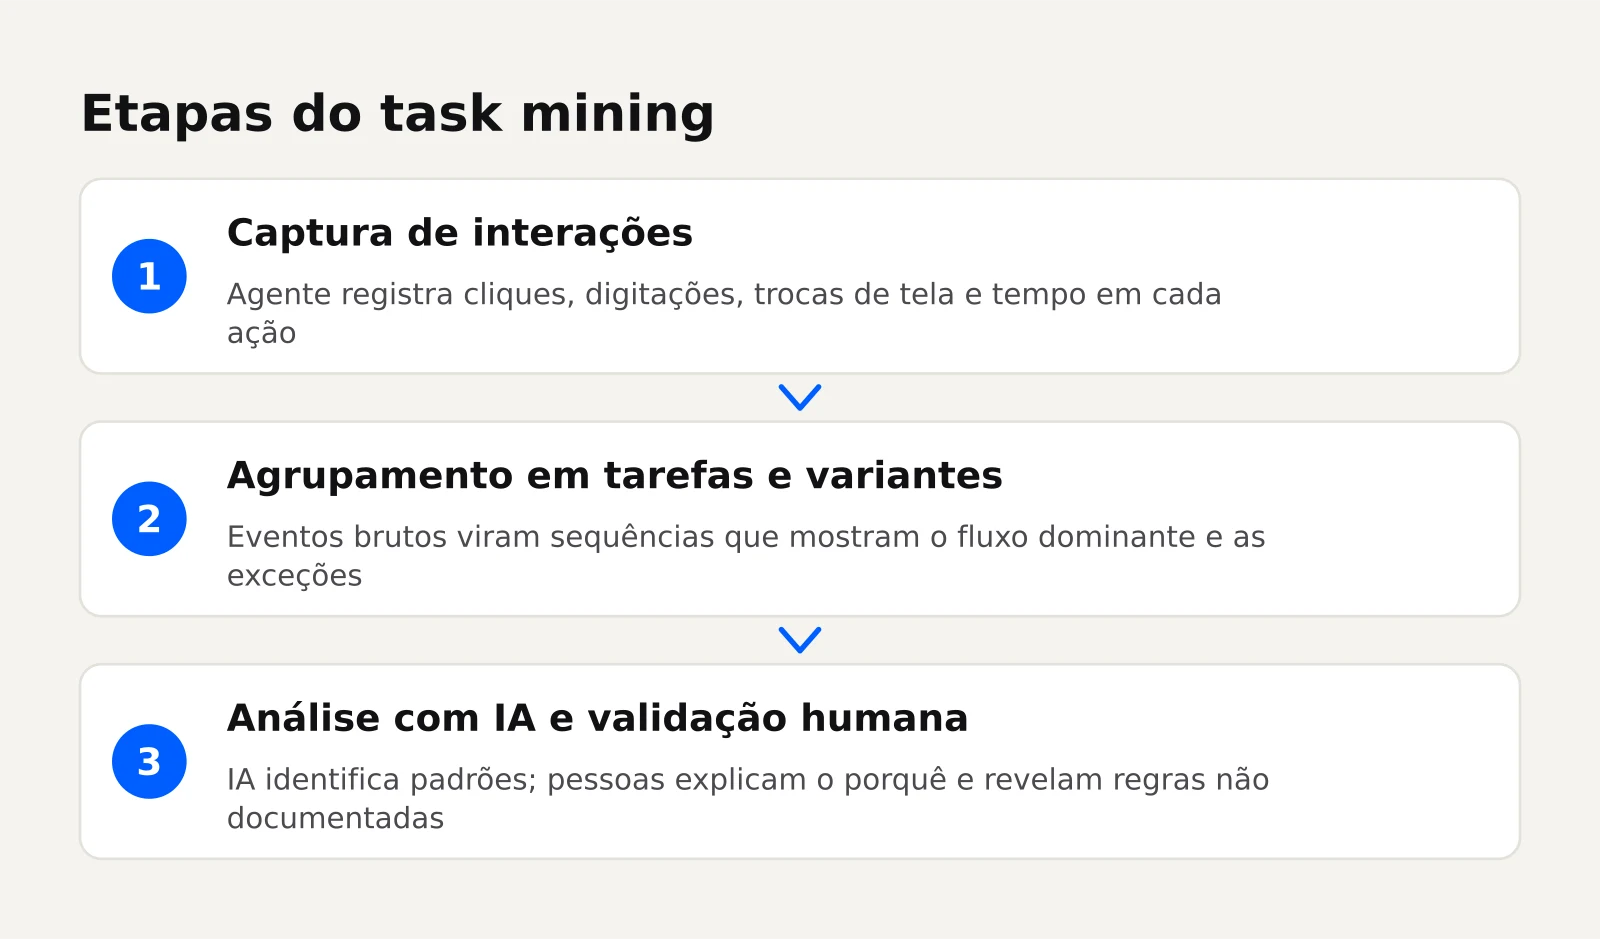
O funcionamento do task mining segue uma sequência lógica: capturar interações, agrupar ações em tarefas e variantes, e então analisar os padrões com apoio de IA e validação humana. Cada etapa responde a uma pergunta diferente sobre o trabalho real.
Captura de interações na tela e nos sistemas
A captura começa com um agente instalado na estação de trabalho das pessoas que executam as tarefas sob análise. Esse agente registra eventos de interface: qual janela está ativa, qual campo recebeu dados, qual botão foi acionado, quanto tempo passou entre uma ação e a seguinte. Em muitos casos, a captura também inclui capturas de tela ou gravações curtas, usadas para contextualizar o que os eventos indicam.
O registro é contínuo durante o expediente, mas o foco da análise costuma ser direcionado a processos específicos. Em uma operação de logística, por exemplo, a captura pode se concentrar nas tarefas de fechamento de rota no ERP e na planilha de apoio. Em um time de qualidade, nas etapas de registro de não conformidades e geração de relatórios.
Um ponto que merece atenção desde o início: a transparência com o time é condição para o método funcionar, como veremos adiante.
Agrupamento de ações em tarefas e variantes
Depois da captura, os eventos brutos são agrupados em sequências que representam tarefas. Uma tarefa pode ser "lançar pedido no ERP", "atualizar planilha de fechamento de rota" ou "conferir certificado de fornecedor". O agrupamento identifica quando uma tarefa começa e termina, mesmo que a pessoa alterne entre janelas no meio do caminho.
Dentro de cada tarefa, a análise revela variantes: as diferentes formas como a mesma tarefa é executada. Uma variante pode ser o caminho direto, sem desvios. Outra pode incluir uma conferência extra no sistema. Uma terceira pode envolver a abertura de uma planilha paralela para recalcular algo que o ERP não calcula. A distribuição das variantes mostra qual é o fluxo dominante e quais são as exceções.
Essa visão de variantes é uma das contribuições mais práticas do task mining. Ela transforma a pergunta "como esse processo funciona?" em "quais são as formas reais, qual é a mais frequente e onde estão os desvios que custam tempo?". Para quem precisa decidir o que automatizar, essa granularidade muda o nível da conversa.
Análise assistida por IA e validação com as pessoas
Com os dados agrupados, entra a análise. Aqui, a IA ajuda a identificar padrões que seriam difíceis de enxergar manualmente: sequências que quase sempre aparecem juntas, etapas que geram retrabalho, horários em que certas variantes se concentram. O analista humano interpreta esses padrões à luz do contexto do negócio.
Mas a análise não termina no algoritmo. A validação com quem executa a tarefa é indispensável. O task mining mostra o que aconteceu; as pessoas explicam por quê. Uma etapa que parece desnecessária pode existir por uma regra não escrita, uma exigência de cliente ou uma limitação do sistema que só quem opera conhece. Sem essa conversa, o risco é automatizar uma tarefa com base em uma leitura incompleta dos dados.
Em projetos de automação, essa etapa de validação costuma revelar as regras que nunca foram documentadas. É o tipo de descoberta que muda o escopo da automação e evita surpresas na implementação. Um fluxograma de processos construído só a partir da documentação oficial raramente captura essas nuances; o task mining, combinado com a conversa, chega mais perto.
Task mining, process mining e RPA: o que cada um responde
Os três termos aparecem juntos com frequência, mas respondem a perguntas diferentes. Entender a distinção evita comprar a abordagem errada para o problema que você tem.
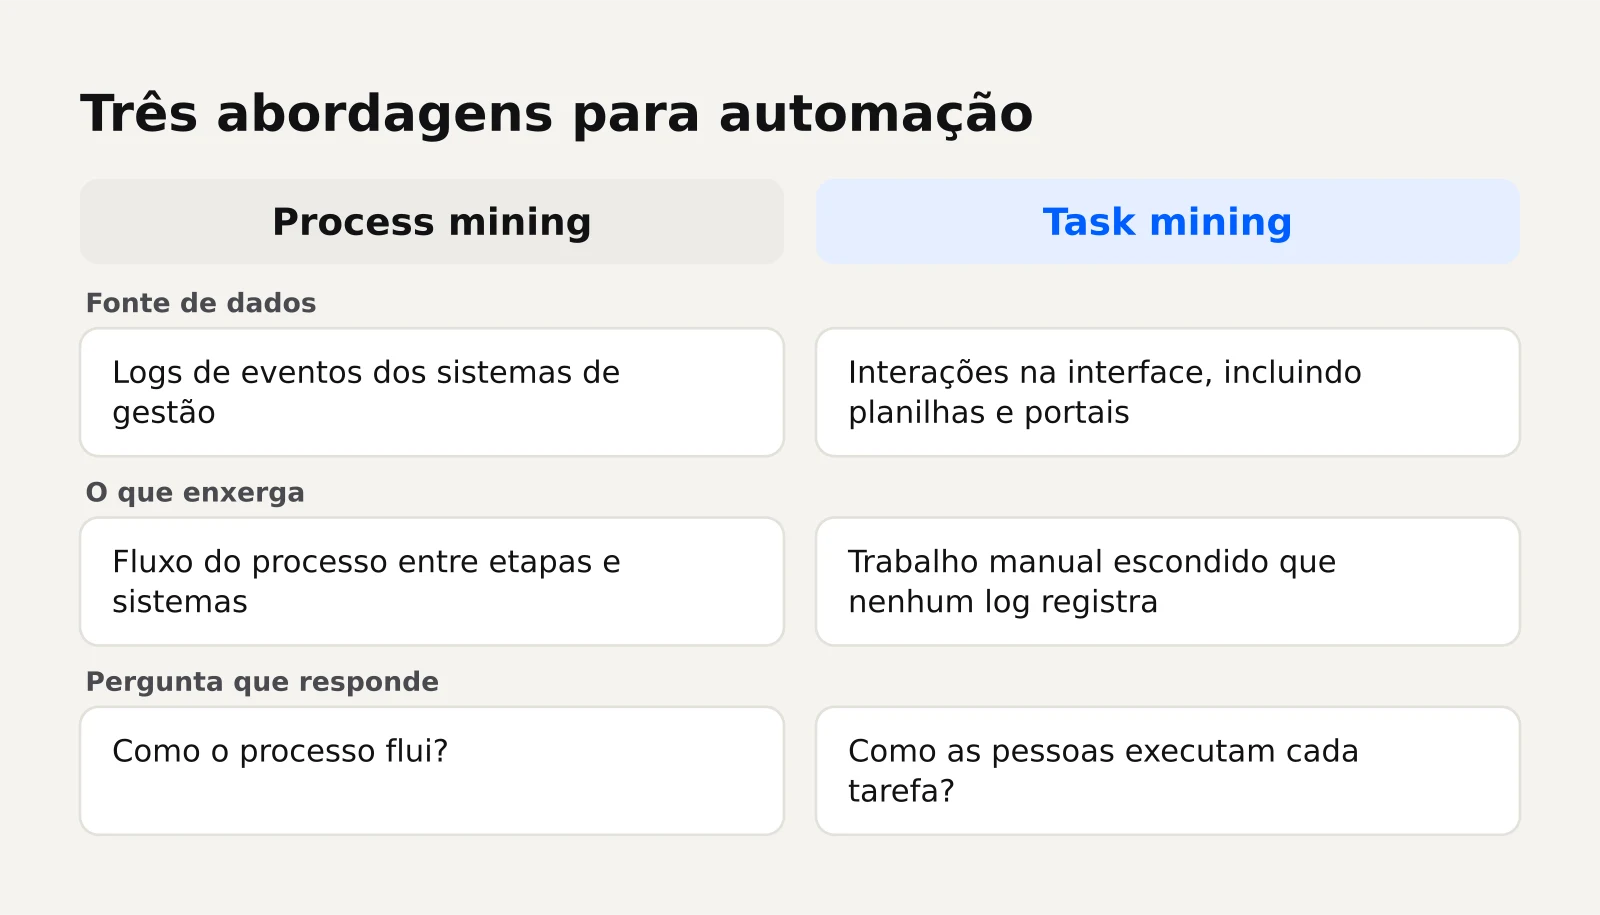
- Process mining analisa os logs de eventos que os sistemas de gestão já geram, como trilhas de auditoria do ERP. Ele reconstrói o fluxo do processo a partir desses registros, mostrando gargalos, desvios e tempos de ciclo. Responde: como o processo flui entre etapas e sistemas?
- Task mining captura as interações na interface, incluindo o que acontece fora dos sistemas formais, como planilhas e portais. Responde: como as pessoas executam cada tarefa no dia a dia, incluindo o trabalho que nenhum log registra?
- RPA (automação robótica de processos) executa tarefas repetitivas imitando as ações humanas na interface. Responde: como automatizar uma tarefa específica sem alterar o sistema de origem?
Na prática, as três abordagens se complementam. O process mining mostra onde o processo emperra; o task mining revela o esforço manual escondido nas tarefas; o RPA executa a automação daquilo que se decidiu automatizar. Uma empresa pode usar process mining para mapear o fluxo de pedidos, task mining para entender o trabalho de conferência e lançamento, e RPA para automatizar a digitação repetitiva.
A diferença essencial para a decisão de automação é esta: o task mining enxerga o trabalho que os sistemas não enxergam. Se a sua operação tem planilhas paralelas, portais sem API e tarefas que dependem de copiar e colar, o process mining sozinho deixará lacunas importantes. O task mining cobre exatamente esse espaço.
Como identificar tarefas candidatas à automação
O task mining gera um volume grande de dados. O desafio não é encontrar tarefas repetitivas, é escolher quais delas valem o esforço de automatizar. Para isso, você precisa de critérios objetivos e de uma leitura cuidadosa dos sinais que os dados mostram.
Critérios de priorização: frequência, padronização, esforço e risco
Quatro critérios ajudam a ordenar as tarefas candidatas. Eles podem ser aplicados em conjunto, como um filtro progressivo.
- Frequência: quantas vezes a tarefa é executada por dia, semana ou mês. Tarefas muito frequentes justificam automação mesmo que cada execução seja rápida, porque o custo se acumula.
- Padronização: o quanto a tarefa segue um padrão estável. Quanto mais variantes e exceções, mais complexa fica a automação e maior o risco de erro.
- Esforço: tempo médio por execução e número de pessoas envolvidas. Tarefas longas ou executadas por várias pessoas em paralelo têm maior potencial de ganho.
- Risco: o impacto de um erro na execução e a sensibilidade dos dados envolvidos. Tarefas de alto risco exigem validação humana ou automação com supervisão.
Uma forma simples de usar esses critérios é pontuar cada tarefa em uma escala qualitativa e ordenar as candidatas. Tarefas com alta frequência, alta padronização, esforço relevante e risco controlado são as primeiras da fila. Uma matriz de priorização ajuda a tornar essa escolha visual e discutível com o time.
Sinais de tarefa automatizável nos dados de interação
Os dados de task mining revelam padrões que indicam forte potencial de automação. Alguns sinais são diretos; outros exigem interpretação.
- Sequências idênticas que se repetem muitas vezes: a mesma ordem de cliques e digitações aparece em dezenas ou centenas de execuções, com pouca variação.
- Copiar e colar entre sistemas: dados saem de um lugar e entram em outro sem transformação relevante. É o caso clássico de ponte manual entre sistemas que não se integram.
- Planilhas paralelas ao ERP: a pessoa mantém uma planilha de apoio porque o sistema não calcula ou não organiza o que ela precisa. O task mining mostra o vaivém constante entre o ERP e a planilha.
- Retrabalho em uma mesma etapa: a pessoa digita, apaga, digita de novo, volta para conferir. Isso pode indicar regra mal definida, campo ambíguo ou falta de validação no sistema.
- Pausas longas e previsíveis: esperas entre uma ação e outra que seguem um padrão, como aguardar uma tela carregar ou conferir um dado em outro lugar.
Esses sinais, isolados, não garantem que a automação vale a pena. Mas quando aparecem combinados e em tarefas de alta frequência, formam um caso forte para avançar.
Tarefas que parecem repetitivas mas não devem ser automatizadas
Nem toda repetição é sinônimo de automação. Algumas tarefas parecem candidatas perfeitas nos dados, mas escondem complexidade que inviabiliza ou desaconselha a automação.
- Tarefas com muitas exceções não documentadas: se cada execução tem um desvio diferente e as regras não estão claras, a automação pode gerar mais correção do que ganho.
- Tarefas que exigem julgamento humano constante: decisões que dependem de contexto, relacionamento ou interpretação de informações ambíguas não são boas candidatas à automação total.
- Tarefas de alto risco sem possibilidade de supervisão: se um erro pode causar prejuízo relevante e não há como validar a saída, a automação precisa ser desenhada com cuidado, talvez com revisão humana obrigatória.
- Tarefas executadas raramente: automatizar algo que acontece uma vez por mês pode não justificar o esforço de construção e manutenção, a menos que o tempo por execução seja muito alto.
- Tarefas que dependem de sistemas instáveis: se a interface muda com frequência ou o sistema trava, a automação exigirá manutenção constante.
O valor do task mining aqui é duplo: ele mostra tanto o que automatizar quanto o que não automatizar. Descartar uma candidata com base em dados é tão importante quanto selecionar uma. Automatizar a tarefa errada consome tempo, gera frustração e pode até aumentar o retrabalho em vez de reduzi-lo.
Da descoberta ao pipeline: validar, priorizar e medir resultados
Descobrir tarefas candidatas é só o começo. Transformar essa descoberta em automação exige um caminho estruturado, com validação, priorização e medição de resultados.
O primeiro passo depois da análise é validar os achados com quem executa. Apresente as variantes encontradas, os tempos medidos e os sinais de retrabalho. Pergunte se aquilo faz sentido, o que explica os desvios e quais regras não estão documentadas. Essa conversa costuma revelar informações que os dados não mostram e que mudam o desenho da automação.
Em seguida, priorize com critérios explícitos. A matriz de priorização mencionada antes ajuda a transformar uma lista longa de candidatas em uma fila curta e defensável. O objetivo não é automatizar tudo de uma vez, e sim escolher as tarefas com melhor relação entre ganho esperado e esforço de implementação.
Depois vem a definição de como medir o resultado. Antes de automatizar, registre a linha de base: tempo médio por execução, número de execuções por período, taxa de erro, horas por semana dedicadas à tarefa. Depois da automação, compare. Sem essa medição, fica difícil saber se o esforço valeu a pena.
Por fim, alimente o pipeline de automação. As descobertas do task mining viram insumo para um programa contínuo de melhoria. Tarefas que não foram priorizadas agora podem entrar na fila depois. Novas capturas podem revelar mudanças no trabalho real. O task mining não é um projeto pontual; é uma capacidade de enxergar a operação de forma contínua.
Para quem está começando a estruturar esse caminho, o artigo sobre automação de fluxo de trabalho detalha como transformar uma tarefa identificada em um fluxo automatizado com etapas claras.
Privacidade e relação com o time
Task mining envolve registrar o trabalho de pessoas reais. Isso coloca privacidade no centro da implementação, não como um detalhe burocrático, mas como condição para o método funcionar.
O primeiro ponto é a transparência sobre o que será capturado e para quê. As pessoas precisam saber que a ferramenta registrará interações, por quanto tempo, em quais tarefas, e o que será feito com os dados.
O segundo ponto é o enquadramento da iniciativa. Task mining não deve ser apresentado como vigilância de produtividade individual. O objetivo é entender o trabalho para melhorar processos, reduzir retrabalho e eliminar tarefas que não agregam valor. Quando o time entende isso e participa da validação, a resistência diminui e a qualidade das descobertas aumenta.
Uma política de inteligência artificial bem definida ajuda a estabelecer as regras de uso e proteção de dados antes de iniciar qualquer captura. Isso vale tanto para task mining quanto para outras iniciativas de IA na operação.
O que define o custo e o esforço de implantação de task mining
O custo de um projeto de task mining não é uma tabela fixa; ele depende de um conjunto de fatores que variam conforme a operação. Entender esses fatores ajuda a dimensionar o esforço antes de pedir propostas.
- Número de pessoas e estações envolvidas: quantas pessoas terão a captura instalada e por quanto tempo. Quanto maior o grupo, maior o volume de dados e o esforço de gestão.
- Escopo dos processos analisados: analisar uma tarefa específica é mais simples do que mapear dezenas de processos em áreas diferentes. O escopo define o tempo de análise e validação.
- Complexidade dos sistemas envolvidos: tarefas que atravessam muitos aplicativos, planilhas e portais geram dados mais difíceis de agrupar e interpretar.
- Necessidade de mascaramento e conformidade: operações com dados sensíveis exigem configurações adicionais de privacidade, o que aumenta o esforço técnico.
- Profundidade da análise e da validação: uma análise superficial é rápida, mas pouco útil. A validação com o time, as entrevistas e a interpretação das variantes tomam tempo e fazem a diferença no resultado.
- Integração com o pipeline de automação: se o objetivo é apenas entender o trabalho, o esforço é um. Se o objetivo é gerar um pipeline de automações priorizadas, há trabalho adicional de desenho, especificação e medição.
Nenhum desses fatores, isolado, define o custo. É a combinação deles que determina o tamanho do projeto. Por isso, propostas sérias começam com um diagnóstico do escopo, dos sistemas e das pessoas envolvidas, e não com um valor fechado.
Erros comuns ao usar task mining para escolher automações
Mesmo com bons dados, é possível tomar decisões ruins. Alguns erros aparecem com frequência em projetos de task mining voltados à automação.
- Automatizar antes de entender as exceções: os dados mostram a variante dominante, mas as exceções podem representar uma parte relevante do trabalho. Ignorá-las gera uma automação que resolve metade do problema e cria retrabalho na outra metade.
- Confiar nos dados sem validar com as pessoas: o task mining mostra o que aconteceu, não o porquê. Pular a conversa com quem executa leva a interpretações erradas e a automações que não resolvem o problema real.
- Priorizar pela intuição em vez de critérios: escolher a tarefa que "parece" mais importante, sem comparar frequência, padronização, esforço e risco, tende a gerar uma fila de automação desbalanceada.
- Tratar task mining como vigilância: usar a ferramenta para cobrar produtividade individual destrói a confiança e compromete a qualidade dos dados. O time passa a esconder o trabalho real, e a análise perde valor.
- Esperar que a ferramenta entregue a decisão pronta: task mining gera dados e padrões, mas a decisão sobre o que automatizar exige julgamento de negócio. A ferramenta apoia; não substitui.
Evitar esses erros não exige mais tecnologia, e sim mais método. A combinação de dados bem capturados, validação com as pessoas e critérios claros de priorização é o que separa projetos que geram resultado de projetos que só geram relatórios.
Perguntas frequentes sobre task mining
Task mining substitui o mapeamento de processos tradicional?
Não. O task mining complementa o mapeamento tradicional. O mapeamento documenta o fluxo desenhado, as regras e as responsabilidades; o task mining revela como o trabalho realmente acontece, incluindo desvios e tarefas que não estão em nenhum documento. Os dois juntos dão uma visão mais completa. Usar apenas o task mining sem o contexto do processo pode levar a interpretações erradas; usar apenas o mapeamento tradicional deixa invisível o esforço manual escondido nas tarefas.
Quanto tempo leva para o task mining gerar descobertas úteis?
Depende do escopo e da frequência das tarefas. Para tarefas executadas muitas vezes por dia, padrões claros podem aparecer em poucas semanas de captura. Para tarefas menos frequentes, o período de coleta precisa ser maior. O tempo de análise e validação com o time também pesa.
Task mining funciona em qualquer tipo de empresa?
Funciona melhor em operações com volume relevante de trabalho repetitivo em sistemas, planilhas e portais. Em indústrias e B2B, áreas como back-office, logística, qualidade, compras e comercial técnico costumam concentrar esse perfil. Empresas muito pequenas, com poucas execuções de cada tarefa, podem não justificar o esforço. O critério principal é a repetição: se as tarefas se repetem com frequência e envolvem interação com sistemas, há material para o task mining analisar.
Task mining exige trocar o ERP ou dar acesso ao banco de dados?
Não. O task mining captura as interações na interface, sem exigir acesso ao banco de dados nem alteração nos sistemas. É justamente essa característica que permite enxergar o trabalho em planilhas paralelas, portais sem integração e sistemas legados. A captura acontece na camada da interface, registrando o que a pessoa faz na tela. Isso torna a abordagem viável mesmo quando o ERP não oferece APIs ou quando a integração direta é cara ou arriscada.
Qual a diferença entre task mining e monitoramento de produtividade?
O objetivo e o uso dos dados são diferentes. O monitoramento de produtividade mede o desempenho individual, muitas vezes para cobrança. O task mining analisa padrões de trabalho para entender processos e identificar oportunidades de melhoria e automação.
Precisa de ajuda com isso?
Se você quer identificar quais tarefas da sua operação valem automatizar e transformar essa descoberta em automações que geram resultado medido, uma conversa de diagnóstico com a Studio Artemis pode ser o próximo passo.


